
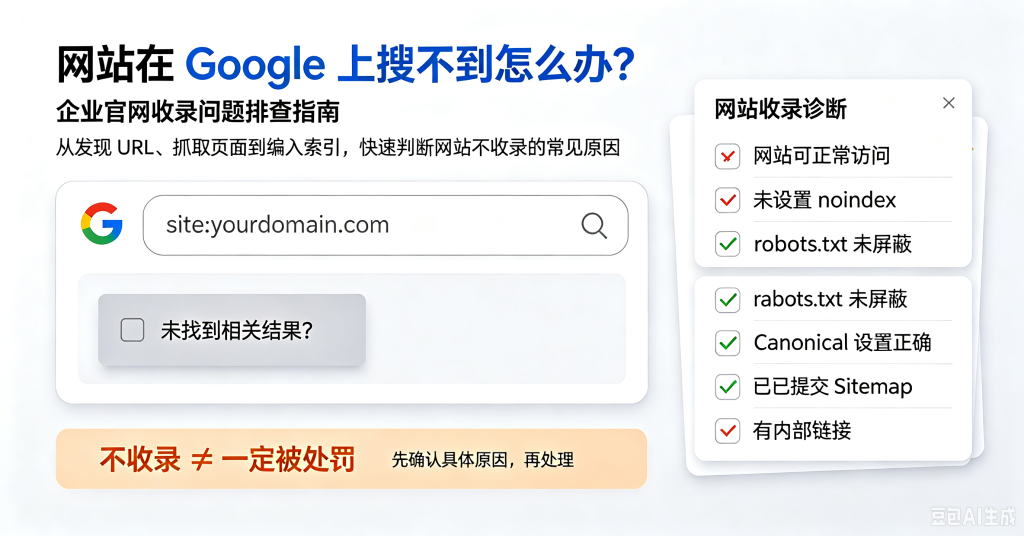
网站已经上线,客户却在 Google 上搜不到;或者在 Google Search Console 中看到“未编入索引”“已发现,当前未编入索引”“已抓取,当前未编入索引”等提示——这是不少外贸企业网站都会遇到的问题。
先说结论:网站在 Google 上搜不到,不一定代表网站被处罚,也不代表只要提交一次 Sitemap 就一定会收录。 企业需要先判断页面是“还没被 Google 发现”“发现了但没有抓取”“已抓取但没有收录”,还是因为技术设置、重复页面、内容质量或网站结构问题而无法正常进入索引。
本文会按实际排查顺序,讲清楚企业官网为什么不收录、如何在 Google Search Console 中确认问题,以及网站上线后应如何提高重点页面被 Google 抓取和收录的机会。
一、先确认:网站是真的没有收录吗?
很多企业通过直接搜索公司名称或产品词,没有找到自己的网站,就认为网站没有被 Google 收录。
但这两种情况并不完全相同:
- 没有收录:Google 数据库中没有这个页面,用户搜索时无法找到。
- 已经收录但没有排名:Google 已知道并收录该页面,但页面暂时没有在目标关键词的靠前位置展示。
- 搜索方式不准确:客户只搜索一个竞争很强的产品大词,网站排在第 10 页以后,误以为没有收录。
- 搜索地区或语言不同:不同国家、语言、设备和个性化搜索环境下,排名表现可能不同。
最简单的初步判断方式,是在 Google 搜索框输入:
textsite:你的域名.com
例如:
textsite:yourdomain.com
如果能看到页面结果,说明 Google 至少已经收录了部分页面。
但 site: 搜索只能作为快速参考,不能完全代替 Google Search Console。要判断某一个 URL 能否被收录、Google 上次是否抓取、规范页是否正确,建议使用 Google Search Console 的“网址检查”工具。
建议操作
- 登录 Google Search Console。
- 在顶部“检查任何网址”输入框中,粘贴需要检查的完整 URL。
- 查看“网址是否在 Google 中”“网页是否可以编入索引”“用户声明的规范网页”“Google 选择的规范网页”“上次抓取时间”等信息。
- 如果页面刚刚修改或刚发布,可在确认页面没有技术问题后点击“请求编入索引”。
不要只靠搜索引擎页面是否出现来判断,也不要每天反复提交同一个 URL。先确认具体原因,再针对性处理。
二、Google 收录一个页面,要经过哪些步骤?
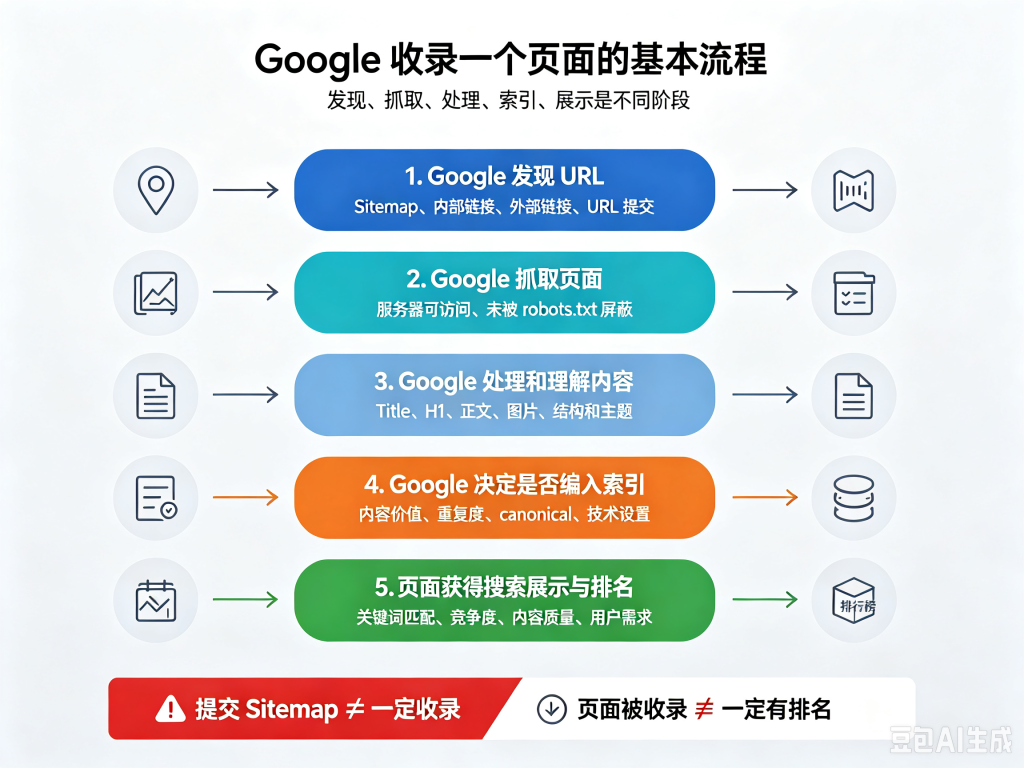
企业常把“提交 Sitemap”“Google 抓取”“Google 收录”“关键词排名”理解成同一件事,但它们实际上是不同阶段。
一个新页面通常会经历以下路径:
textGoogle 发现 URL
        ↓
Google 抓取页面
        ↓
Google 处理和理解页面内容
        ↓
Google 选择是否编入索引
        ↓
页面在相关搜索中获得展示与排名
1. Google 发现 URL
Google 可能通过以下方式发现新页面:
- XML Sitemap。
- 网站导航、分类页、相关文章和正文内部链接。
- 其他网站指向该页面的链接。
- Google 之前已经抓取过的网站更新。
- Google Search Console 中的 URL 检查和请求编入索引。
Google 官方建议 Sitemap 中应放入希望被索引的规范 URL,并可通过 Search Console 提交 Sitemap;CMS 生成的 Sitemap 也可直接使用。Sitemap 可以帮助 Google 发现 URL,但它不是“提交后保证收录”的指令。
2. Google 抓取页面
Googlebot 发现页面后,会访问服务器并读取 HTML、CSS、JavaScript、图片及页面资源。
如果网站服务器不稳定、加载过慢、robots.txt 错误屏蔽、页面需要登录、存在大量重复参数 URL,或网站本身有太多低价值页面,Google 可能降低抓取频率或延后抓取。
3. Google 判断是否收录
即使 Google 成功抓取页面,也不意味着一定会把它放入索引。
Google 会综合判断页面是否具备独立价值、是否与其他页面高度重复、是否存在规范化冲突、是否可被正常访问,以及内容是否有助于用户。
所以,“已抓取,当前未编入索引”通常不一定是单纯技术错误,也可能表示 Google 已读取页面,但暂时没有认为它需要进入搜索索引。
4. 收录不等于排名
页面进入 Google 索引后,仍然需要与其他页面竞争相关搜索词的展示机会。
因此:
text能收录 ≠ 有排名
有排名 ≠ 有点击
有点击 ≠ 有询盘
企业网站应该先解决收录和可抓取性问题,再通过关键词布局、页面内容、内链、外链、用户体验与转化路径,逐步提升自然搜索表现。
如果您正在新建外贸官网,也建议在设计和开发阶段同步考虑页面结构、关键词、Title、内链和上线检查。关于完整顺序,可阅读 外贸建站和 Google SEO 应该一起做吗?企业官网获客的正确顺序。
三、Google Search Console 常见的“未收录”状态
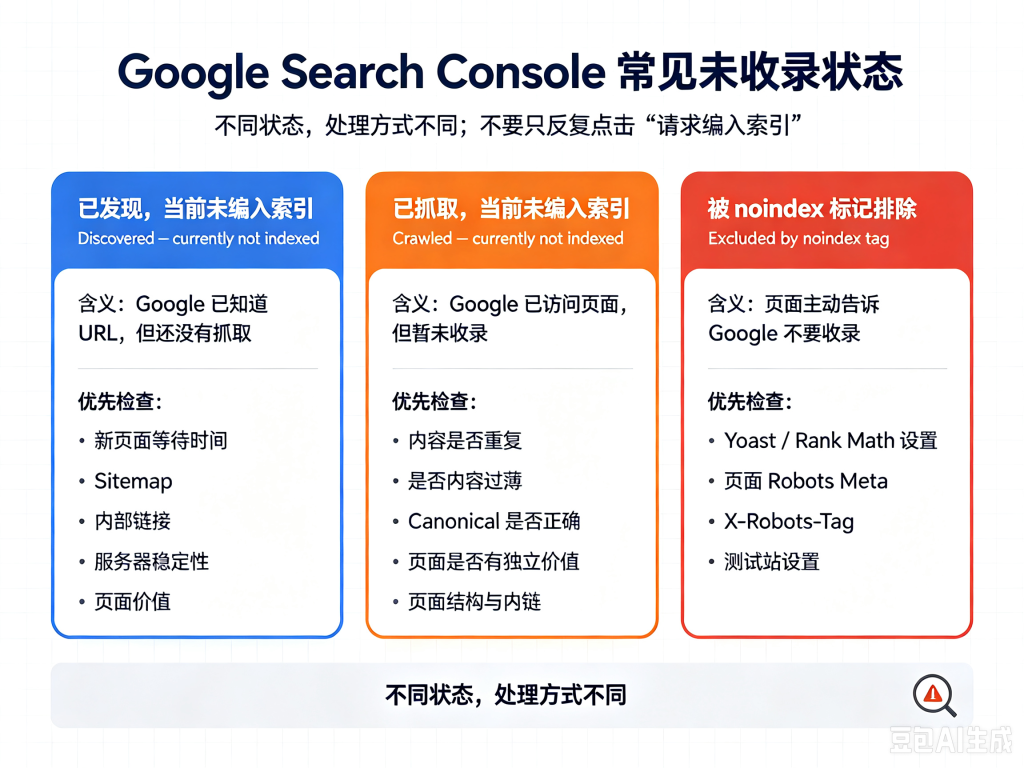
Google Search Console 的“网页索引编制”报告中会出现不同状态。不同状态代表的问题不同,不能全部用“提交索引”解决。
1. 已发现,当前未编入索引
英文通常为:
textDiscovered – currently not indexed
意思是:Google 已经知道这个 URL 存在,但还没有抓取该页面。
它可能来自 Sitemap、内链、外链或 Google 之前发现的网站地址。Google Search Central 社区的解释指出,这一状态代表 Google 已发现 URL,但尚未抓取,页面尚不能被索引;如果只是少量新页面出现这个状态,有时只需要等待 Google 后续安排抓取。
常见原因包括:
- 网站或页面刚上线,Google 还没有安排抓取。
- 网站整体内容较少,抓取优先级较低。
- 服务器响应较慢或不稳定,Google 不希望增加网站负担。
- Sitemap 中包含太多低价值、重复、跳转或非规范 URL。
- 网站有大量分页、标签页、参数页、站内搜索页等无效 URL。
- 重点页面缺少导航、分类页或正文内链支持。
- 网站内容重复度高,Google 对抓取价值判断较低。
建议处理方法
- 确认页面可以正常打开,并返回 200 状态码。
- 确认该页面没有
noindex、密码限制、登录限制或 robots.txt 屏蔽。 - 检查页面是否位于 XML Sitemap 中。
- 从首页、产品分类页、相关文章或高权重页面增加一条相关的正文内链。
- 补充页面独有内容,包括产品信息、服务说明、参数、应用、案例、FAQ 或原创图片。
- 检查服务器速度、稳定性和错误日志。
- 对少量重要新页面,可通过 URL 检查工具请求编入索引。
- 不要反复提交大量内容相似、价值有限的页面。
2. 已抓取,当前未编入索引
英文通常为:
textCrawled – currently not indexed
意思是:Google 已经抓取过页面,但暂时没有将页面放入索引。
与“已发现,当前未编入索引”不同,这个状态说明 Google 已经访问过页面。因此,重点应从“如何让 Google 来抓取”转向“为什么 Google 暂时不选择收录这个页面”。
常见原因包括:
- 页面内容过短,无法提供独立信息。
- 多个产品页、标签页或文章页内容高度重复。
- 页面只是替换产品名称、图片或少量参数的模板化内容。
- 页面没有清晰的主标题、结构或页面主题。
- 页面与网站其他 URL 的内容相近,Google 选择了另一个规范页面。
- 页面存在软 404、空内容、加载异常或 JavaScript 渲染问题。
- 页面质量不足,无法满足用户实际搜索需求。
- 大量 AI 批量生成内容,但缺乏企业真实信息、专业说明、案例或人工审核。
建议处理方法
- 增加与其他页面不同的具体内容,而不是单纯扩写字数。
- 为产品页增加规格、材料、工艺、应用、定制能力、认证、交期、FAQ、相关案例和询盘说明。
- 合并内容高度重复、没有独立搜索价值的页面。
- 检查 canonical 是否指向自己,还是错误指向其他页面。
- 检查页面源代码和实际渲染内容是否一致。
- 让该页面获得来自分类页、产品页、案例页或相关文章的相关内链。
- 更新后等待 Google 重新抓取;不要用反复提交索引代替内容和技术修复。
3. 被“noindex”标记排除
如果 GSC 显示:
text已排除:被“noindex”标记排除
通常说明页面 HTML 或 HTTP 响应头中存在禁止收录的指令。
常见写法是:
xml<meta name="robots" content="noindex">
Google 说明,noindex 指令用于阻止页面出现在搜索结果中;Googlebot 抓取并读取到该标签或 HTTP Header 后,会将页面从 Google 搜索结果中移除。developers.google+1
建议处理方法
如果这是一个希望获得搜索流量的产品页、服务页、案例页或博客文章:
- 检查 WordPress、Yoast SEO、Rank Math 或其他 SEO 插件的页面级 Robots 设置。
- 确认是否错误启用了“禁止搜索引擎显示此页面”或“noindex”。
- 检查网站是否仍处于测试模式、维护模式或“阻止搜索引擎索引本站”状态。
- 检查服务器是否通过
X-Robots-Tag返回了noindex。 - 移除
noindex后,确保页面允许抓取,再通过 Search Console 请求编入索引。
需要注意:如果页面本来就不应该参与搜索,例如后台页、站内搜索结果页、重复筛选页、隐私页面的某些变体或内部测试页,保留 noindex 是正常的,不要为了“收录数量更多”全部改为 index。
4. 被 robots.txt 屏蔽
robots.txt 用来告诉爬虫哪些路径不应抓取。
但很多企业在网站迁移、安装插件或复制测试站时,会误把重要页面、整个目录,甚至整站都屏蔽掉。
例如:
textUser-agent: *
Disallow: /
这个规则会阻止大部分搜索引擎抓取整站内容。
建议处理方法
- 访问:
texthttps://你的域名.com/robots.txt
- 检查是否有错误的
Disallow: /。 - 检查产品页、博客、案例、分类页所在目录是否被屏蔽。
- 不要随意屏蔽 CSS、JavaScript 等 Google 用于理解页面渲染效果的重要资源。
- 如果页面需要从索引中移除,不要只依赖 robots.txt;应根据实际情况使用
noindex、301、404/410 或 canonical 等方法。
需要特别注意:如果你希望 Google 读取页面上的 noindex,就不能先通过 robots.txt 把该页面完全禁止抓取。Google 无法抓取页面,也就无法读取其中的 noindex 指令。developers.google+1
5. 重复网页,Google 选择了其他规范页
这类状态通常表示:Google 发现多个 URL 的内容非常相似,因此没有收录当前 URL,而选择了另一个版本作为规范页。
常见场景包括:
http和https版本并存。- 带
www和不带www的版本并存。 - 带和不带末尾
/的 URL 可同时访问。 - 同一产品存在多个分类路径。
- URL 带有广告追踪参数、筛选参数或排序参数。
- WordPress 标签页、分类页、作者页、附件页与正文内容重复。
- 多语言页面没有正确标注语言与对应关系。
- 产品页复制后只修改了少量词语。
建议处理方法
- 统一网站首选域名,例如只保留一个 HTTPS 版本。
- 让非首选版本通过 301 跳转到首选 URL。
- 使用 canonical 指向真正希望收录的标准页面。
- XML Sitemap 中只保留 200 状态、可索引、canonical 指向自身的页面。
- 规范页要保留实际内容和内部链接支持,不能只设置标签却让页面内容质量很差。
- 对不需要单独排名的重复页、筛选页、内部搜索页,可根据实际情况设置
noindex或避免生成。
四、网站在 Google 上搜不到的 10 个排查项目
当你发现一个重点页面没有收录时,可按下面顺序排查,而不是一上来就反复提交索引。
1. 页面是否能正常打开?
用无痕窗口访问完整 URL,确认页面不是:
- 404 页面。
- 500 服务器错误。
- 白屏。
- 跳转循环。
- 需要登录或输入密码。
- 访问后自动跳转到无关页面。
- 移动端与电脑端显示完全不同或无法加载。
理想状态是:重点页面返回 HTTP 200,并能够让普通用户正常访问。
2. 页面是否被设为 noindex?
检查 Yoast SEO、Rank Math 或网站 SEO 插件中的 Robots 设置。
对于希望获得 Google 流量的文章、产品页、服务页和案例页,通常应为:
textindex, follow
不要误设为:
textnoindex, nofollow
3. robots.txt 是否误屏蔽?
检查:
texthttps://你的域名.com/robots.txt
确认重点内容目录没有被 Disallow。
4. Canonical 是否正确?
查看页面源代码,搜索:
xmlrel="canonical"
正常情况下,一个希望收录的独立页面,应优先声明自身为规范 URL,例如:
xml<link rel="canonical" href="https://www.example.com/product-page/" />
如果当前文章的 canonical 指向首页、分类页或另一篇文章,Google 可能不收录当前 URL。
5. 页面是否出现在 XML Sitemap?
打开 Sitemap,确认重点页面是否被包含。
常见地址包括:
texthttps://你的域名.com/sitemap.xml
或:
texthttps://你的域名.com/sitemap_index.xml
Google 建议 Sitemap 中只放入绝对 URL、规范 URL;可以使用 CMS 自动生成,也可以在 Search Console 的 Sitemap 报告中提交并查看处理情况。
6. 页面是否有内部链接?
一篇新文章发布后,不要只等 Google 从 Sitemap 发现它。
至少从以下其中一个页面加入相关内链:
- 首页的最新文章区。
- 博客/新闻分类页。
- 相关文章模块。
- 一篇主题高度相关的旧文章正文。
- 核心服务页。
- 行业案例页。
例如,本文发布后,可以从《外贸建站和 Google SEO 应该一起做吗?企业官网获客的正确顺序》一文中的“上线检查与持续 SEO”部分,添加一条内链:
xml网站上线后,应通过 Google Search Console 监测收录状态。若重点页面迟迟无法收录,可参考<a href="【本文 URL】">网站在 Google 上搜不到怎么办?企业官网收录问题排查指南</a>。
7. 页面内容是否有独立价值?
不要只看文章有多少字,而要问:
- 用户为什么需要看这个页面?
- 页面是否回答了一个明确问题?
- 内容是否有企业的实际经验、案例、流程、图片、数据或观点?
- 这篇文章与网站其他文章有什么明显不同?
- 产品页是否提供了足够的规格、应用和采购信息?
- 用户看完后是否知道下一步该做什么?
对于企业官网,特别是产品、服务、案例和行业应用页,应尽量加入企业自己的真实材料:工厂图片、检测流程、产品参数、服务边界、实际案例、常见客户问题、交期逻辑、认证信息与咨询路径。
8. 是否存在大量重复或低价值页面?
如果网站有大量重复页面,Google 可能降低对网站整体内容的抓取和处理优先级。
常见低价值页面包括:
- 只修改标题或产品型号的重复产品页。
- 自动生成的大量标签页。
- 无内容的分类页、作者页、附件页。
- 站内搜索结果页。
- 带筛选条件的参数 URL。
- 只有一两段通用文字的“城市 + 产品”页面。
- 批量 AI 生成、没有真实企业信息和人工校验的文章。
不建议通过不断增加薄内容页面来追求“收录量”。企业更应优先确保核心产品页、服务页、案例页和高价值文章可被正常发现、抓取和理解。
9. 服务器与网站速度是否稳定?
如果服务器经常超时、响应慢、页面资源加载失败,Googlebot 可能降低抓取频率。
可检查:
- 网站是否经常出现 5xx 错误。
- 是否使用稳定的主机和 CDN。
- 图片、视频、插件是否导致页面过重。
- 是否有错误的缓存、压缩或安全规则拦截 Googlebot。
- 是否存在大量重定向链。
- 是否有 WordPress 插件冲突或数据库报错。
10. 是新页面,还是长期问题?
一篇刚发布几天的文章没有立即收录,通常不必过度焦虑。
但如果重点产品页、服务页或文章已经发布较长时间,并且确认:
- 页面可访问;
- 没有 noindex;
- 没有 robots.txt 屏蔽;
- canonical 正确;
- 已加入 Sitemap;
- 已有相关内链;
- 内容具备独立价值;
仍长期无法被收录,就需要进一步检查整站抓取质量、服务器日志、重复页面、站点结构、历史域名问题和 Google Search Console 报告。
五、网站上线后如何提高重点页面的收录机会?
下面是一份适用于新站与更新站点的实用清单。
发布前
- 确认文章或页面解决一个明确的客户问题。
- 设置独立的 Title、H1、Meta Description。
- 检查正文是否有真实、独立、有用的信息。
- 添加 1–3 条与内容相关的内部链接。
- 添加清晰的 CTA,例如询盘表单、WhatsApp、邮箱或相关服务链接。
- 压缩图片并填写符合图片内容的 Alt Text。
- 确认页面允许
index, follow。 - 确认 canonical 指向自身的正式 URL。
- 确认页面不是草稿、私密、密码保护或测试环境版本。
发布后
- 检查页面前台是否能正常访问。
- 确认页面已自动进入 XML Sitemap。
- 从一篇相关旧文章或核心服务页增加内链。
- 在 Google Search Console 的 URL 检查工具中检查页面。
- 对核心新页面可提交“请求编入索引”。
- 观察 GSC 的网页索引编制报告。
- 不要频繁改 URL、Title、H1 和正文主题。
- 等待 Google 抓取和处理,同时继续建设其他高质量核心页面。
Google 官方说明,提交 Sitemap 后,可以在 Search Console 的 Sitemaps 报告中查看 Googlebot 访问情况和处理错误;Sitemap 中应包含规范、绝对 URL。
六、常见误区:这些做法不一定能解决收录问题
误区 1:不断点击“请求编入索引”
“请求编入索引”适合少量重要的新页面或已修复的重点页面,但不是收录保证。
如果页面本身存在 noindex、robots 屏蔽、错误 canonical、低质量内容、重复内容或服务器异常,反复请求不会从根本上解决问题。
误区 2:只要提交 Sitemap,所有页面都会收录
Sitemap 是 URL 发现与管理工具,不是收录承诺。
如果 Sitemap 里有大量跳转、404、重复、noindex、参数页或低价值 URL,反而会让网站的 Sitemap 质量变差。应优先提交你真正希望 Google 收录的规范页面。
误区 3:收录越多越好
企业网站的目标不是让每个标签页、筛选页、附件页和参数 URL 都被收录,而是让重要的产品页、服务页、案例页、行业应用页和高价值文章被正确收录并获得目标客户的访问。
误区 4:页面不收录就是被处罚
多数情况下,未收录不等于人工处罚或算法惩罚。页面可能只是新、缺少抓取入口、内容重复、价值不足、规范化信号混乱或网站技术设置异常。
只有在 Google Search Console 的“人工处置措施”或“安全问题”中有明确提示时,才需要按对应问题处理。
七、什么时候应该找技术 SEO 人员排查?
如果出现下面情况,建议不要只靠“提交 Sitemap”或“多发文章”解决,而应做一次完整的网站技术 SEO 检查:
- 整个网站大量页面长期不被 Google 收录。
- 网站首页也无法被收录。
- GSC 显示大量 robots.txt 屏蔽、noindex、重复网页或服务器错误。
- 网站改版、换域名、换 CMS 后流量大幅下降。
- 旧 URL 没有正确跳转到新 URL。
- 页面 canonical 大量错误指向首页或其他无关 URL。
- WordPress 出现数据库报错、插件冲突或异常跳转。
- Sitemap 中存在大量 404、重定向、非规范页。
- 网站有大量自动生成页面、参数 URL、重复产品内容。
- 网站自然流量、收录数和关键词排名持续下降。
对于已有网站,正确顺序通常是先找出索引、抓取、结构和内容问题,再确定后续关键词、内容更新、内链和外链策略,而不是直接开始发布大量新文章。
获取网站 SEO 诊断建议
OnePound 可根据企业网站的行业、目标市场、网站基础与获客目标,提供 Google SEO、网站收录与抓取排查、技术 SEO 诊断、内容优化和持续数据分析建议。
如果您的网站已经上线,但 Google 收录、关键词排名、自然流量或询盘效果不理想,可查看 已有网站 SEO 优化服务,提交网站地址并获取初步问题排查方向。
如果您正在准备新建外贸官网,建议在上线前同步完成关键词研究、页面结构、基础技术 SEO 与询盘路径规划。您可以查看 OnePound 建站 + SEO 优化套餐,获取适合自身业务的页面规划与报价建议。
 粤公网安备:44011302001007号
